关于在爬虫过程中遇到各类型验证码的处理方式
共 6217字,需浏览 13分钟
·
2026-04-02 10:51
技术背景:
在电商数据采集、舆情监控、价格监测等商业爬虫场景中,验证码已成为网站反爬体系的核心防线。随着前端技术与风控策略升级,验证码从早期简单数字字母组合,逐步演进为滑块拼图、图文点选、行为验证、无感验证等复杂形态,广泛出现在登录、详情页访问、搜索查询等关键环节。
传统爬虫依赖静态请求与基础解析,面对动态验证码频繁中断,手动输入效率极低,无法满足批量、持续的数据采集需求。同时,不同站点验证码逻辑差异大、加密参数多变,导致开发者需反复调试,大幅增加开发与维护成本,也成为制约爬虫稳定性与自动化程度的主要瓶颈。
本文立足合规数据采集前提,聚焦爬虫实战中高频出现的各类验证码,梳理从基础到高阶的系统化处理思路。旨在帮助开发者快速定位验证码类型,选择适配方案,平衡识别准确率、执行效率与工程落地成本。通过整合图像处理、OCR 识别、深度学习、第三方接口等技术,构建 “类型判断→方案选型→代码实现→异常容错” 的完整处理流程,降低验证码对爬虫的拦截影响,提升自动化采集的稳定性与通用性。同时强调技术边界与合规原则,为商业级爬虫项目提供可复用、易维护的验证码解决方案,助力开发者高效突破反爬限制,保障数据采集业务稳定运行。
下面,我将从不同类型验证码的各个场景总结出一些我个人常用的识别方案,便于大家进行选择性学习和使用。
技术实现:
在爬虫实战中,验证码的处理核心是“精准识别+模拟验证”,不同类型的验证码,其识别逻辑与技术选型差异较大。以下针对图形验证码、滑动验证码、点选验证码三大高频场景,分别拆解不同解决方案的实现细节、适用场景及核心代码思路,所有方案均基于Python语言实现,贴合Scrapy、Playwright等主流爬虫技术栈,可直接复用至商业项目。实现一次编写,终身复用。
场景:图形验证码的识别
图形验证码是最基础、最常见的验证码类型,核心形态为“数字+字母”组合、汉字组合、图文混合(如干扰线、噪点、旋转扭曲),主要用于简单的反爬拦截,常见于网站登录、注册、单次请求验证等环节。其识别核心是“提取验证码图像中的有效字符”,以下三种方案从易到难,适配不同项目的成本与准确率需求。
方案一:基于调用第三方大模型的识别
该方案是目前最便捷、适配性最强的图形验证码识别方式,依托第三方大模型(如百度AI、阿里云OCR、腾讯云OCR)的图像识别能力,无需手动处理图像干扰、字符扭曲等问题,仅需调用API接口,传入验证码图像,即可快速返回识别结果。适合中小规模爬虫、快速验证需求,以及复杂图形验证码(如旋转字母、带噪点数字)的识别,优势是开发成本低、识别准确率高,劣势是存在API调用费用,大规模采集时需控制成本。
核心实现步骤:
1. 爬虫中定位图形验证码元素,通过Playwright/Selenium截图,或直接获取验证码图片URL并下载,保存为本地图像文件(如png、jpg格式);
2. 注册第三方大模型平台账号,获取API密钥(如百度AI的API Key、Secret Key);
3. 编写代码调用API接口,传入图像文件路径或Base64编码,设置识别参数(如识别类型为“数字字母混合”“汉字”);4. 接收API返回的识别结果,进行简单校验(如长度匹配),若识别失败则重试2-3次,仍失败则触发异常处理(如手动介入或跳过该请求)。
下面我来演示一下如何用代码实现以上操作,这里以调用豆包14 pro大模型为例。
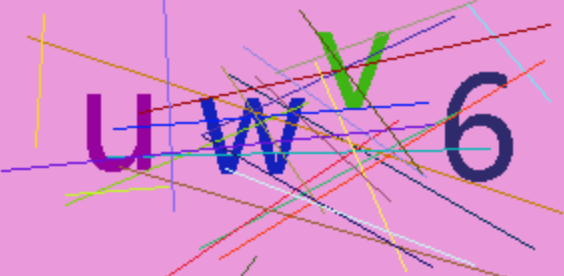
示例验证码:
示例代码:
from openai import OpenAI

import os

import base64

from dotenv import load_dotenv


# 加载配置

load_dotenv()

API_KEY = os.getenv("ARK_API_KEY", "你的API-KEY")


MODEL_ID = "你的大模型入口ID"


# 初始化客户端

client = OpenAI(

    base_url="https://ark.cn-beijing.volces.com/api/v3",

    api_key=API_KEY,

)


def image_to_base64(image_path):

    """将本地图片转为Base64编码(推荐方式)"""

    with open(image_path, "rb") as f:

        base64_data = base64.b64encode(f.read()).decode("utf-8")

    return f"data:image/png;base64,{base64_data}"  # 拼接Base64前缀


def ask_doubao_with_image(prompt: str, image_path: str = None,

                          system_prompt: str = "你是一个专业的技术助手,简洁准确地回答问题。") -> str:

    """

    调用豆包API,支持文本+图片提问

    :param prompt: 用户问题

    :param image_path: 本地图片路径(可选)

    :param system_prompt: 系统角色设定

    :return: 模型回答

    """

    try:

        # 构造消息体

        messages = [{"role": "system", "content": system_prompt}]


        # 构建用户消息(文本+图片)

        user_content = []

        # 1. 添加文本内容

        user_content.append({"type": "text", "text": prompt})

        # 2. 若有图片,添加Base64格式的图片

        if image_path and os.path.exists(image_path):

            img_base64 = image_to_base64(image_path)

            user_content.append({

                "type": "image_url",

                "image_url": {"url": img_base64}

            })


        messages.append({"role": "user", "content": user_content})


        # 调用API

        response = client.chat.completions.create(

            model=MODEL_ID,

            messages=messages,

            temperature=0.7,

            max_tokens=2048  # 图片解析需更大的token额度

        )

        return response.choices[0].message.content.strip()


    except Exception as e:

        return f"调用失败:{str(e)}"


# 测试调用(替换为你的图片路径)

if __name__ == "__main__":

    # 示例1:仅文本提问

    # result = ask_doubao_with_image(prompt="请介绍一下你自己")


    # 示例2:文本+图片提问

    result = ask_doubao_with_image(

        prompt="我发送给你了一张验证码图片,请你识别图中的验证码并给我输出验证码的内容,注意,我只要验证码内容,其余的内容一个字也不要输出",

        image_path="E:/yzm.png"  # 替换为你的本地图片路径

    )

    # print("豆包回答:\n", result)

    print(result)
运行结果:
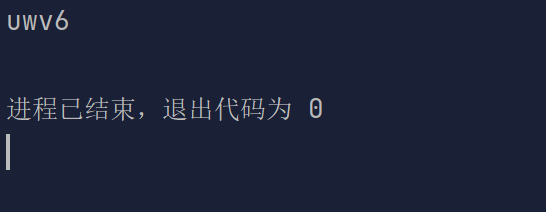
可以看到这种方式的识别正确率还是很高的,当然了,即使小概率失败了也不用担心,我可以用代码实现错误重试,比如爬虫脚本在输入完验证码点击验证之后可以进行断言,如果验证失败,就再次调用一下获取验证码的接口,这里就不再演示具体的代码了,本文只聚焦于如何识别验证码。
方案二:基于调用在线打码平台的识别
在线打码平台依托人工打码或半自动识别技术,适用于第三方大模型识别准确率较低的场景(如高度扭曲、复杂干扰线、特殊字体的图形验证码),核心优势是识别准确率高(接近人工),劣势是调用速度较慢、存在打码费用,且部分平台稳定性不足。常见的在线打码平台有超级鹰、云打码、斐斐打码等,操作流程与第三方大模型类似,均为调用API接口传入验证码图像,获取识别结果。
核心实现步骤:
1. 注册在线打码平台账号,充值打码点数,获取平台提供的API账号、密码、软件ID;
2. 爬虫中获取验证码图像(截图或下载),按平台要求格式化图像(如压缩尺寸、转为指定格式);
3. 调用平台API接口,传入图像数据、账号密码等参数,发起打码请求;
4. 接收平台返回的识别结果,校验后用于验证码提交,若识别失败则申请重新打码(部分平台支持),或触发重试逻辑。
核心代码示例(以超级鹰为例):
首先创建一个接口文件
chaojiying.py
import requests

from hashlib import md5


class Chaojiying(object):


    def __init__(self, username, password, soft_id):

        self.username = username

        self.password = md5(password.encode('utf-8')).hexdigest()

        self.soft_id = soft_id

        self.base_params = {

            'user': self.username,

            'pass2': self.password,

            'softid': self.soft_id,

        }

        self.headers = {

            'User-Agent': 'Mozilla/4.0 (compatible; MSIE 8.0; Windows NT 5.1; Trident/4.0)',

        }


    def post_pic(self, im, codetype):

        """

        im: 图片字节

        codetype: 题目类型 参考 http://www.chaojiying.com/price.html

        """

        params = {

            'codetype': codetype,

        }

        params.update(self.base_params)

        files = {'userfile': ('ccc.jpg', im)}

        r = requests.post('http://upload.chaojiying.net/Upload/Processing.php', data=params, files=files,

                          headers=self.headers)

        return r.json()


    def report_error(self, im_id):

        """

        im_id:报错题目的图片ID

        """

        params = {

            'id': im_id,

        }

        params.update(self.base_params)

        r = requests.post('http://upload.chaojiying.net/Upload/ReportError.php', data=params, headers=self.headers)

        return r.json()
然后在爬虫脚本中导入并调用这个接口:
from chaojiying import Chaojiying


def get_coords():

    username = '你的用户名'

    password = '你的密码'

    soft_id = '你的ID'

    captcha_kind = '9101'

    filename = './img/captcha.png' # 验证码图片文件路径


    client = Chaojiying(username, password, soft_id)

    result = client.post_pic(open(filename, 'rb').read(), captcha_kind)

    coords = result['pic_str']

    final_coords = '{' + str(coords) + '}'


    return final_coords


if __name__ == '__main__':

    print(get_coords())
对于其它类型验证码的识别方案几乎都可以使用在线打码平台来完成自动化,超级鹰这个平台也提供了几乎所有类型的验证码识别接口。
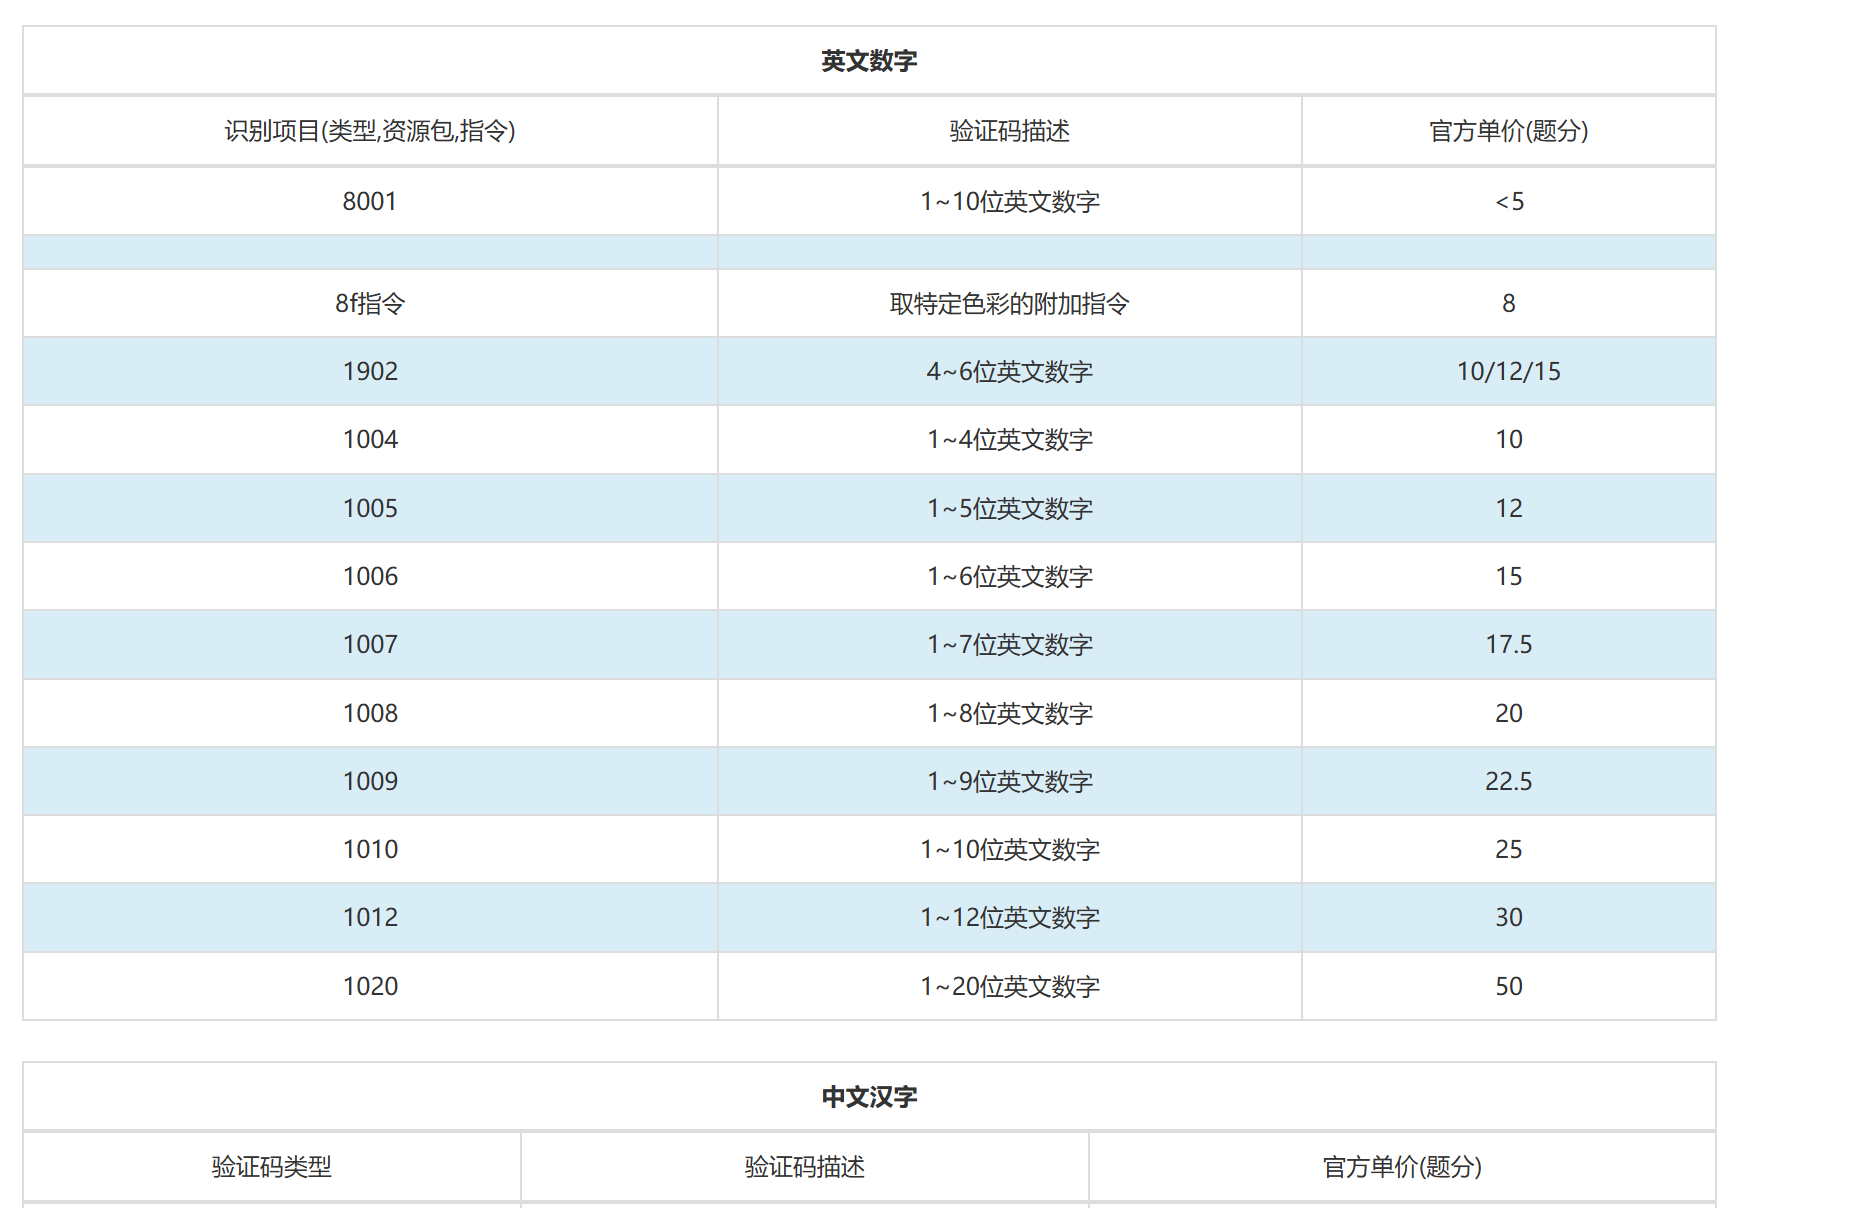
在线打码平台是付费的,如果你不想付费,当然也可以自行搭建一个简易的打码平台,脚本将验证码图片发送到你的站点接口,然后你手动识别验证码内容。
两种方式有利有弊,付费的可以做到自动化,自行搭建就需要人工操作,大家可以自己权衡利弊一下。